Angenommen, zwei Tracker laufen eine Woche lang auf derselben Seite. Einer erfasst 700 Besuche, der andere 900. Es liegt nahe, die Differenz als 200 blockierte Besuche zu bezeichnen. Dafür fehlen aber Informationen, die keiner der beiden Gesamtwerte enthält.
Selbst wenn jeder Mensch nur einmal kommt und beide Tracker jeden empfangenen Besuch fehlerfrei zählen, bleibt unbekannt, wie viele Besuche beiden entgehen. Die Gesamtwerte verraten nicht einmal, welche Besuche in beiden Systemen vorkommen.
Das wird wichtig, sobald jemand das grössere Dashboard als Korrekturfaktor für das kleinere verwendet. Das Verhältnis zweier beobachteter Gruppen misst nicht die Gruppe ausserhalb beider Systeme.
Die fehlende Zelle
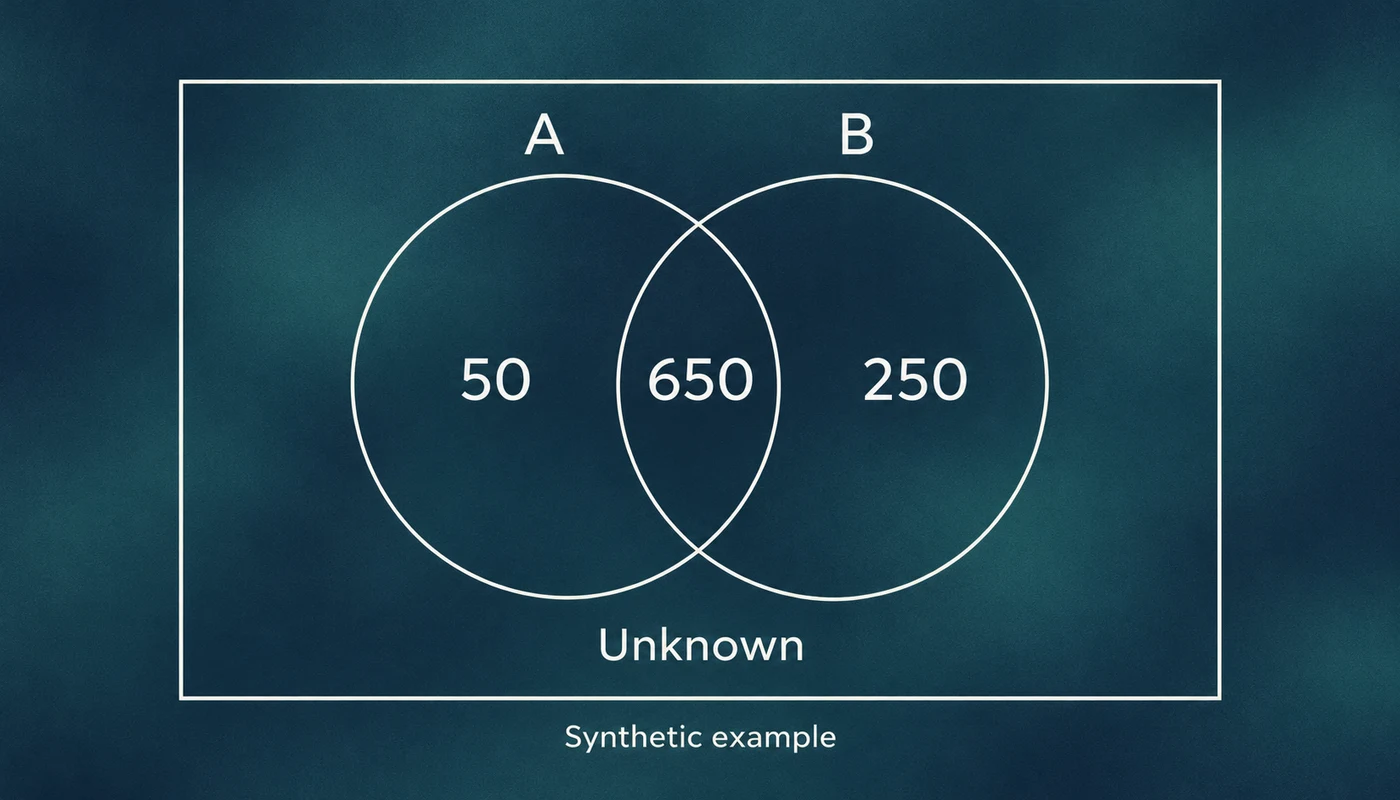
Das folgende Beispiel ist synthetisch und enthält keine Zenovay-Daten. In einem festen Zeitraum von sieben Tagen hat jeder berücksichtigte Besuch genau eine Gelegenheit, an jeden Tracker ein Ereignis zu senden. Alle empfangenen Ereignisse sind gültig. Beide Systeme definieren einen Besuch gleich.
| Beobachtung | Besuche |
|---|---|
| Von beiden Trackern empfangen | 650 |
| Nur von A empfangen | 50 |
| Nur von B empfangen | 250 |
| Von keinem empfangen | Unbekannt |
A meldet 700, B meldet 900. Gemeinsam haben sie 950 verschiedene Besuche beobachtet. Ihre Differenz beträgt 200, obwohl B 250 Besuche erfasst hat, die A fehlen, und A 50, die B fehlen.
Ohne die Überschneidung einzelner Ereignisse ist auch die Vereinigungsmenge von 950 unbekannt. Selbst mit dieser Überschneidung bleibt die unbeobachtete Zelle offen. Kommen 50 Besuche hinzu, die keinem Tracker vorliegen, beträgt die Gesamtzahl 1.000. Sind es stattdessen 1.050, beträgt sie 2.000. In beiden Dashboards bleiben alle Zahlen unverändert.
# Synthetic visits during one seven-day window.
tracker_a = set(range(700))
tracker_b = set(range(650)) | set(range(700, 950))

assert len(tracker_a) == 700
assert len(tracker_b) == 900
assert len(tracker_a & tracker_b) == 650
assert len(tracker_a | tracker_b) == 950

for unseen in (50, 1050):
    total = len(tracker_a | tracker_b) + unseen
    print(total, round(100 * len(tracker_a) / total, 1))
1000 70.0
2000 35.0
Die beobachteten Zahlen sind also sowohl mit einer Abdeckung von 70 % als auch mit 35 % durch A vereinbar. Das sind konstruierte Möglichkeiten, keine Schätzungen der tatsächlichen Abdeckung.
Warum beiden Trackern dieselben Besuche entgehen
Eine idealisierte Capture-Recapture-Rechnung könnte die Population mit 700 * 900 / 650 auf etwa 969 Besuche schätzen. Zu den Voraussetzungen des Zwei-Listen-Schätzers gehören eine geschlossene Population, korrekte Zuordnung, gleiche Erfassungswahrscheinlichkeiten innerhalb einer Liste und Unabhängigkeit zwischen den Listen. Die Formel belegt nicht, dass zwei Browser-Tracker diese Voraussetzungen erfüllen.
Browser-Tracker teilen sich Fehlerquellen. JavaScript kann deaktiviert sein. Eine Einwilligungsentscheidung kann beide Tags am Laden hindern. Ein Besucher kann die Seite verlassen, bevor eines der Ereignisse gesendet wird. Eine Inhaltsfilterregel kann beide Erfassungsendpunkte blockieren. Wer für A schwer zu beobachten ist, kann auch für B schwer zu beobachten sein. Ohne weitere Belege ist die Annahme unabhängiger Erfassung deshalb unsicher.
Ein historisches Beispiel liefert Plausibles Vergleich seiner Zahlen mit Google Analytics. In der Diskussion auf Hacker News wurde der Nenner hinterfragt: Besuche, die beiden Tools fehlen, fehlen auch im Vergleich. Dieser kann die Differenz der konkreten Implementierungen bei dieser Zielgruppe beschreiben. Eine allgemeingültige Blockierungsrate belegt er nicht.
Auch ein erfolgreicher Browser-API-Aufruf beweist noch keinen Eingang im System. sendBeacon() gibt true zurück, wenn der Browser die Daten zum Versand eingereiht hat. Das ist keine Empfangsbestätigung der Analytics-Datenbank. Unterscheiden Sie bei der Fehlersuche zwischen Versandwarteschlange, Annahme am Erfassungsendpunkt und Darstellung im Bericht.
Das Serverlog ist ein weiterer Beobachtungsweg
Ein HTTP-Log hilft bei anderen Fragen. Aus Anfragen werden dadurch aber keine Menschen.
Eine Anfrage kann von einem Crawler oder einer Linkvorschau stammen. Ein Browser kann dasselbe Dokument mehrfach abrufen. Im Origin-Log können Anfragen fehlen, die ein vorgeschalteter Cache beantwortet hat. Die Protokollierungsebene und der URL-Filter bestimmen den Inhalt der Zählung. Vergleichen Sie zunächst Dokumentanfragen im selben Zeitraum, nicht sämtliche Bilder, Skripte und Verfügbarkeitsprüfungen.
Bei KI-Traffic ist eine weitere Unterscheidung nötig. OpenAI dokumentiert getrennte Agents für Suche, trainingsbezogenes Crawling und nutzerinitiierte Abrufe. Ein Abruf zur Beantwortung einer Frage belegt nicht, dass die fragende Person Ihre Website geöffnet hat. Eine Crawler-Anfrage ist kein menschlicher Besuch über ein KI-Produkt. Trennen Sie diese Kategorien auch beim selben Anbieter.
Auch die Bot-Filterung unterscheidet sich. Google Analytics schliesst bekannte Bots automatisch aus, zeigt bei dieser Funktion aber nicht, wie viele Ereignisse entfernt wurden. Das ist keine Zusicherung, sämtliche Automatisierung zu erkennen. Cloudflare beschreibt seinen Bot-Score als Wahrscheinlichkeitseinschätzung. Weder ein browserähnlicher User-Agent noch ein fehlendes Bot-Label beweist einen menschlichen Ursprung.
Wenn der Server 10.000 und der Browser 6.000 meldet, bleiben nach diesen Zählregeln 4.000 ungeklärte Anfragen. Wer sie als blockierte Menschen bezeichnet, überspringt die Untersuchung.
Besucherzahlen hängen von der Identitätsregel ab
Prüfen Sie vor dem Vergleich, ob beide Berichte dieselbe Einheit zählen. Ein Seitenaufruf kann mehrere Ereignisse auslösen. Mehrere Aufrufe können zu einer Sitzung gehören. Ein Mensch kann mehrere Gerätekennungen haben.
Die Berichtsidentität von GA4 kann User-ID, Gerätekennungen und in der Einstellung «Zusammengeführt» auch Modellierung verwenden. Ein gerätebasierter Bericht und ein Bericht, der angemeldete Aktivitäten zusammenführt, müssen aus denselben Ereignissen nicht dieselbe Nutzerzahl berechnen.
Zenovay hat in seinem cookieless Identitätsmodus eine andere, dokumentierte Grenze: Der Besucherschlüssel wechselt täglich. Eine Rückkehr über diese Grenze hinweg kann einen neuen Schlüssel ergeben. Personen mit denselben Identitätseingaben können zusammengefasst werden. Das folgt aus der Identitätsregel und bedeutet nicht zwangsläufig, dass ein Werbeblocker Ereignisse entfernt hat. Ein Hash macht aus der Kennung keine Zählung von Menschen.
Deshalb lässt sich die wöchentliche Zahl eindeutiger Besucher nicht immer durch Addition der Tageswerte rekonstruieren. Ein stabiler Schlüssel kann über Tage hinweg dedupliziert werden; ein rotierender Schlüssel bietet nicht dieselbe Kontinuität. Klären Sie das Identitätsfenster, bevor eine der Zahlen zum Nenner einer Conversion-Rate wird.
Attribution verändert die Aussage nach der Erfassung
Selbst wenn beide Tools den Kauf erhalten, können sie über die Zuordnung streiten.
Prüfen Sie zuerst den verfügbaren Pfad. Ein fehlender Kampagnenparameter oder Referrer kann Herkunftshinweise löschen. Bei Referrer-Policy: no-referrer lässt der Browser den Referrer weg. Die Standardregel für originübergreifende Anfragen übermittelt in der Regel nur die Herkunftsdomain, nicht den vollständigen Pfad. Ohne verwertbare Quelle ist nicht belegt, dass jemand die Adresse eingetippt hat.
Prüfen Sie danach die Zuordnungsregel. Google beschreibt Attributionsmodelle als Regeln oder Algorithmen zur Verteilung von Beiträgen. In seinen Attributionsberichten bekommen direkte Besuche normalerweise keinen Beitrag, ausser der gesamte Pfad besteht aus direkten Besuchen. Ein Tool, das einfach den letzten erfassten Besuch anrechnet, kann daher von GA4 abweichen, ohne einen Kauf zu verlieren. Unterschiedliche Rückblickfenster können frühere Kontakte schon vor der Modellberechnung ausschliessen.
Eine andere Verteilung verändert den Kauf nicht. Sie rekonstruiert keinen unbeobachteten Erstbesuch und beweist nicht, ob der Kauf ohne Kampagne stattgefunden hätte. Dafür braucht es einen Vergleich, der diese kausale Frage beantworten kann.
Erst ein Ereignis abgleichen, dann eine Gesamtzahl korrigieren
Wählen Sie einen vollständigen Berichtszeitraum und halten Sie fest, wofür jede Zeile steht. Dazu gehören Zeitzone, Hostname-Umfang, Identitätsfenster, Bot-Behandlung und der Einsatz modellierter Daten. Notieren Sie auch den Exportzeitpunkt: Verarbeitung kann einen noch unvollständigen Zeitraum verändern.
Verfolgen Sie danach mit einem autorisierten Testbesuch eine konkrete Aktion. Prüfen Sie Zielseite, Einwilligungsstatus, den Versandversuch des Browsers, die Antwort des Erfassungsendpunkts und das gespeicherte Ereignis. Falls eine synthetische Testkennung sinnvoll ist, halten Sie sie kurzlebig und aus Kundenberichten heraus. Führen Sie keine dauerhafte toolübergreifende Identität ein, nur damit zwei Summen übereinstimmen.
Gleichen Sie bei Käufen stabile Transaktionskennungen und Beträge mit dem Zahlungssystem ab. Berücksichtigen Sie Rückerstattungen und Berichtsfenster. Das prüft erfasste Käufe. Es zeigt weiterhin nicht alle Menschen, die einen Kauf erwogen und die Seite vor der Erfassung verlassen haben.
Ein nützliches Ergebnis kann eng begrenzt sein: «B empfängt diese Testereignisse, A unter dieser Blockierungskonfiguration nicht.» Das lässt sich reproduzieren. «Wir haben 22 % unserer fehlenden Menschen wiedergefunden» braucht einen Nenner, den die beiden Dashboards nicht liefern.