Supongamos que dos herramientas de seguimiento funcionan en la misma página durante una semana. Una registra 700 visitas y la otra 900. Es tentador llamar a la diferencia «200 visitas bloqueadas». Esa conclusión exige información que ninguno de los totales contiene.
Incluso suponiendo una sola visita por persona y que ambas cuentan perfectamente cada evento recibido, seguimos sin saber cuántas visitas se pierden las dos. Los totales ni siquiera indican qué visitas comparten.
Esto importa cuando se usa el panel con el total mayor para corregir el menor. La proporción entre dos poblaciones observadas no mide la población que queda fuera de ambas.
La celda que falta
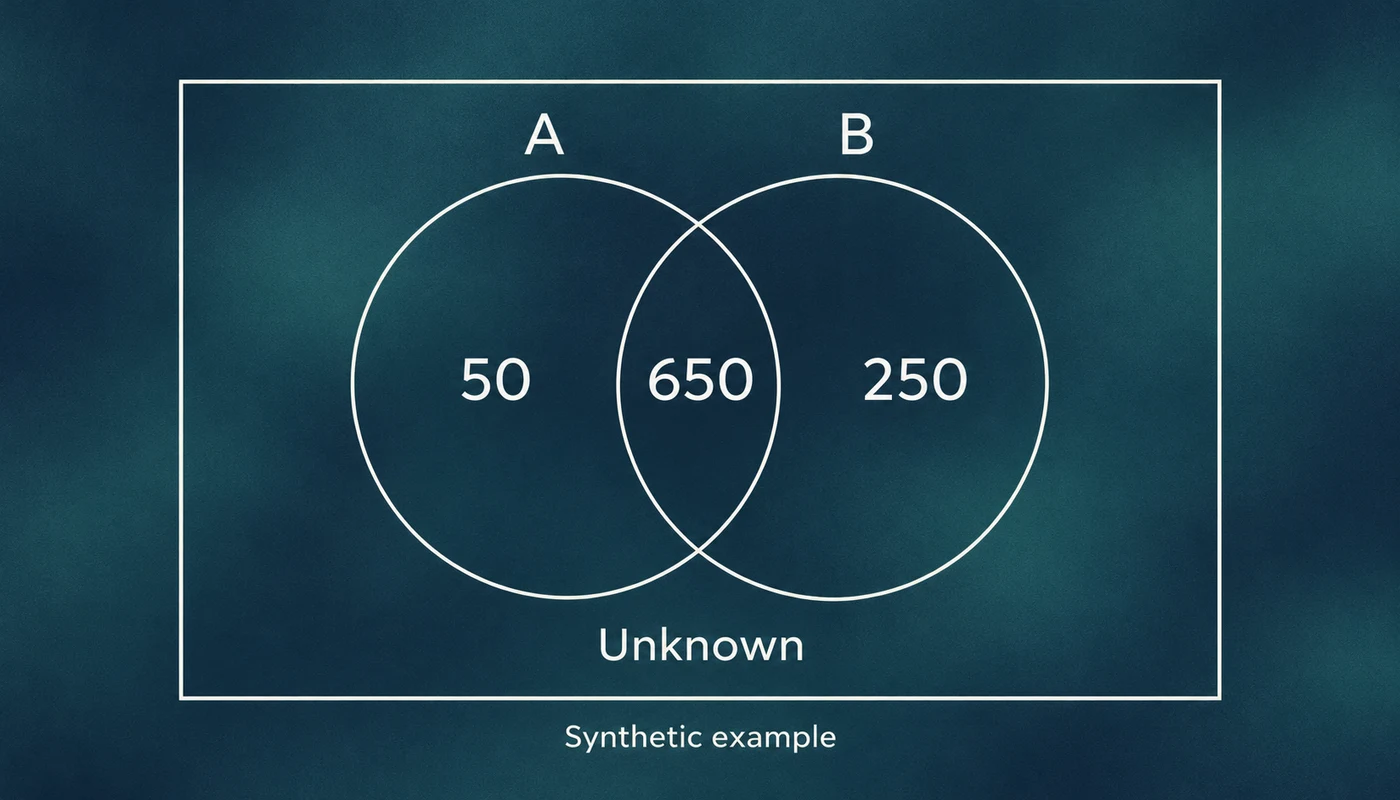
Este ejemplo es sintético, no es tráfico de Zenovay. Durante un periodo fijo de siete días, cada visita elegible tiene exactamente una oportunidad de enviar un evento a cada herramienta. Todos los eventos recibidos son válidos y ambos sistemas definen una visita de la misma forma.
| Observación | Visitas |
|---|---|
| Recibidas por ambas herramientas | 650 |
| Recibidas solo por A | 50 |
| Recibidas solo por B | 250 |
| No recibidas por ninguna | Desconocido |
A muestra 700 y B muestra 900. En conjunto han observado 950 visitas distintas. La diferencia es 200, aunque B observó 250 visitas ausentes de A y A observó 50 ausentes de B.
Sin conocer el solapamiento de los eventos, ni siquiera está disponible la unión de 950. Con ese solapamiento, la celda no observada sigue siendo desconocida. Si añadimos 50 visitas que ninguna recibió, el total es 1.000. Si añadimos 1.050, es 2.000. Los dos paneles mantienen exactamente las mismas cifras.
# Synthetic visits during one seven-day window.
tracker_a = set(range(700))
tracker_b = set(range(650)) | set(range(700, 950))

assert len(tracker_a) == 700
assert len(tracker_b) == 900
assert len(tracker_a & tracker_b) == 650
assert len(tracker_a | tracker_b) == 950

for unseen in (50, 1050):
    total = len(tracker_a | tracker_b) + unseen
    print(total, round(100 * len(tracker_a) / total, 1))
1000 70.0
2000 35.0
Las mismas observaciones son compatibles con que A cubra el 70 % o el 35 % de las visitas. Son posibilidades construidas, no estimaciones de cobertura real.
Por qué ambas herramientas se pierden las mismas visitas
Un cálculo idealizado de captura-recaptura podría estimar una población de 700 * 900 / 650, unas 969 visitas. Los supuestos del estimador de dos listas incluyen una población cerrada, correspondencias correctas, probabilidades de captura iguales dentro de cada lista e independencia entre listas. La fórmula no demuestra que dos herramientas del navegador cumplan esos supuestos.
Comparten causas de fallo. JavaScript puede estar desactivado. Una decisión de consentimiento puede impedir que se carguen ambas etiquetas. El visitante puede cerrar la página antes de que se envíe cualquier evento. Una regla de bloqueo puede afectar a los dos destinos de recopilación. Las visitas difíciles de observar para A también pueden serlo para B. Sin más pruebas, no es seguro asumir independencia.
Un ejemplo histórico es la comparación de Plausible con Google Analytics. La conversación en Hacker News cuestionó el denominador: las visitas ausentes de ambas herramientas también estarían ausentes de la comparación. Esta puede describir la diferencia entre esas implementaciones para ese público. No puede establecer una tasa universal de bloqueo.
Tampoco una llamada exitosa a una API del navegador demuestra que los datos hayan llegado. sendBeacon() devuelve true cuando el navegador pone los datos en cola. No es un recibo de la base de datos de analítica. Al investigar la entrega, distinga entre poner el evento en cola, aceptarlo en el colector y mostrarlo en el informe.
El registro del servidor es otro mecanismo de observación
Usar un registro HTTP como denominador ayuda a responder otras preguntas. No convierte las solicitudes en personas.
Una solicitud puede proceder de un rastreador o de una vista previa de enlace. Un navegador puede pedir varias veces el mismo documento. Un registro del servidor de origen puede omitir las solicitudes atendidas por una caché intermedia. La capa de registro y el filtro de URL determinan qué se cuenta. Empiece por solicitudes de documentos dentro del mismo periodo, no por todas las imágenes, scripts y comprobaciones de disponibilidad.
El tráfico de IA requiere otra distinción. OpenAI documenta agentes separados para búsqueda, rastreo relacionado con entrenamiento y consultas iniciadas por usuarios. Una consulta hecha para responder a alguien no demuestra que esa persona abriera su sitio. Una solicitud de rastreador no es una visita humana referida por un producto de IA. Separe las categorías aunque compartan proveedor.
El filtrado de bots también varía. Google Analytics excluye automáticamente los bots conocidos, pero esa función no muestra cuántos eventos excluyó. No promete reconocer toda la automatización. Cloudflare describe su puntuación de bots como una evaluación de probabilidad. Ni un user-agent parecido al de un navegador ni la ausencia de una etiqueta de bot prueban que hubiera una persona.
Si el servidor indica 10.000 y el navegador 6.000, quedan 4.000 solicitudes sin explicar bajo esas reglas. Llamarlas personas bloqueadas equivale a saltarse la investigación.
El número de visitantes depende de una regla de identidad
Antes de comparar la recopilación, compruebe que los informes cuentan unidades equivalentes. Una carga de página puede emitir varios eventos. Varias cargas pueden pertenecer a una sesión. Una persona puede tener varios identificadores de dispositivo.
La identidad para los informes de GA4 puede usar User-ID, identificadores de dispositivo y, en el modo combinado, modelización. Un informe basado en dispositivos y otro que une actividad de usuarios autenticados no tienen por qué devolver el mismo número de usuarios a partir de los mismos eventos.
Zenovay tiene otro límite documentado en su modo de identidad sin cookies: la clave del visitante cambia cada día. Volver después de ese cambio puede producir otra clave. Personas con las mismas entradas de identidad pueden agruparse. Son consecuencias de la regla de identidad, no eventos que necesariamente eliminó un bloqueador. Aplicar un hash no convierte el identificador en un censo de personas.
Por eso no siempre se puede reconstruir el total semanal de visitantes únicos sumando los valores diarios. Un identificador estable permite deduplicar entre días; uno que cambia no aporta la misma continuidad. Acuerde la ventana de identidad antes de usar cualquiera de esas cifras como denominador de una tasa de conversión.
La atribución cambia el relato después de la recopilación
Aunque ambas herramientas reciban la compra, pueden discrepar sobre quién merece el crédito.
Primero revise el recorrido disponible. La ausencia de un parámetro de campaña o referente puede borrar pruebas de adquisición. Con Referrer-Policy: no-referrer, el navegador omite el referente. La política predeterminada entre orígenes suele enviar el origen, no la ruta completa. Un informe sin fuente utilizable no demuestra que alguien escribiera la dirección.
Después revise la regla de reparto. Google define los modelos de atribución como reglas o algoritmos para asignar crédito. En sus informes de atribución, las visitas directas normalmente no reciben crédito salvo que todo el recorrido sea directo. Una herramienta que acredita simplemente la última visita registrada puede discrepar de GA4 sin perder una compra. Distintas ventanas retrospectivas pueden excluir contactos anteriores antes de ejecutar el modelo.
Cambiar el reparto no cambia la compra. No recupera una primera visita que no se observó ni demuestra si la compra habría ocurrido sin una campaña. Para eso hace falta una comparación diseñada para la pregunta causal.
Conciliar un evento antes de corregir un total
Elija un periodo de informes completo y anote qué representa cada fila. Incluya zona horaria, hostnames incluidos, ventana de identidad, tratamiento de bots y presencia de datos modelizados. Registre cuándo exportó los datos: el procesamiento puede cambiar un periodo incompleto.
Después siga una acción concreta mediante una visita de prueba autorizada. Confirme la página de destino, el consentimiento, la solicitud intentada por el navegador, la respuesta del colector y el evento almacenado. Si conviene un identificador sintético, haga que dure poco y exclúyalo de los informes de clientes. No introduzca una identidad persistente entre herramientas solo para hacer coincidir dos totales.
Para las compras, concilie identificadores de transacción estables e importes con el sistema de pagos, teniendo en cuenta reembolsos y periodo. Eso verifica las compras registradas. Sigue sin mostrar todas las personas que pensaron en comprar y se fueron antes de ser observadas.
El resultado útil puede ser limitado: «B recibe estos eventos de prueba y A no con esta configuración de bloqueo». Es reproducible. «Recuperamos al 22 % de las personas que faltaban» requiere un denominador que los dos paneles no han proporcionado.