Suponha que duas ferramentas de rastreamento rodem na mesma página por uma semana. Uma registra 700 visitas e a outra, 900. É tentador chamar a diferença de 200 visitas bloqueadas. Essa conclusão exige informações que nenhum dos totais contém.
Mesmo supondo uma única visita por pessoa e uma contagem perfeita de cada evento recebido, ainda não sabemos quantas visitas as duas perderam. Os totais nem sequer mostram quais visitas elas têm em comum.
Isso importa quando alguém usa o painel com a contagem maior para corrigir a menor. A razão entre duas populações observadas não mede a população fora de ambas.
A célula que falta
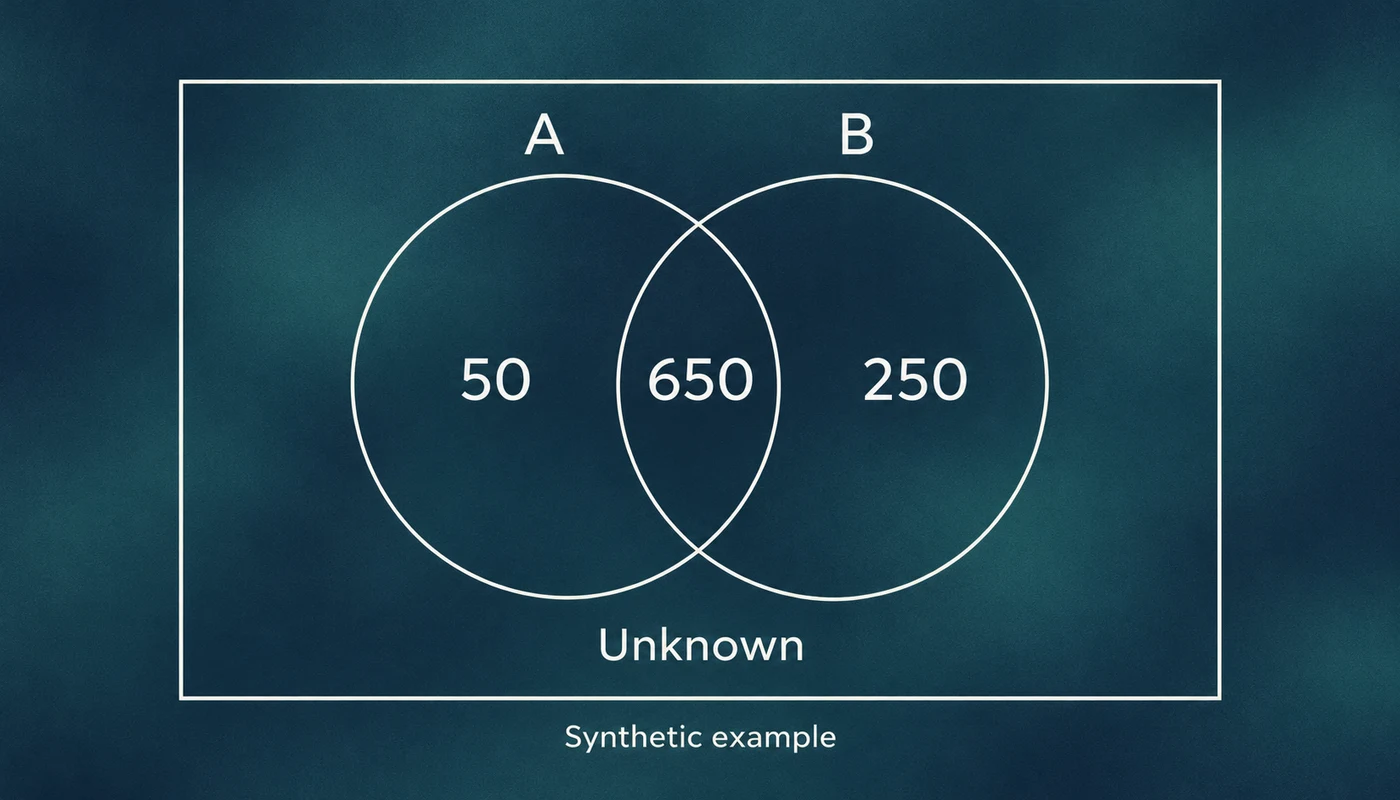
Este exemplo é sintético, não é tráfego do Zenovay. Durante um período fixo de sete dias, cada visita elegível tem exatamente uma oportunidade de enviar um evento a cada ferramenta. Todos os eventos recebidos são válidos e os dois sistemas definem visita da mesma forma.
| Observação | Visitas |
|---|---|
| Recebidas pelas duas ferramentas | 650 |
| Recebidas apenas por A | 50 |
| Recebidas apenas por B | 250 |
| Não recebidas por nenhuma | Desconhecido |
A informa 700 e B, 900. Juntas, observaram 950 visitas distintas. A diferença é 200, embora B tenha observado 250 visitas ausentes de A, enquanto A observou 50 ausentes de B.
Sem a sobreposição entre eventos, nem a união de 950 está disponível. Mesmo com essa sobreposição, a célula não observada continua desconhecida. Acrescente 50 visitas que nenhuma ferramenta recebeu e o total será 1.000. Acrescente 1.050 e será 2.000. Todas as contagens dos dois painéis permanecem iguais.
# Synthetic visits during one seven-day window.
tracker_a = set(range(700))
tracker_b = set(range(650)) | set(range(700, 950))

assert len(tracker_a) == 700
assert len(tracker_b) == 900
assert len(tracker_a & tracker_b) == 650
assert len(tracker_a | tracker_b) == 950

for unseen in (50, 1050):
    total = len(tracker_a | tracker_b) + unseen
    print(total, round(100 * len(tracker_a) / total, 1))
1000 70.0
2000 35.0
As mesmas observações são compatíveis com A cobrindo 70% ou 35% das visitas. São possibilidades construídas, não estimativas da cobertura real.
Por que as duas ferramentas perdem as mesmas visitas
Um cálculo idealizado de captura-recaptura poderia estimar a população como 700 * 900 / 650, cerca de 969 visitas. As premissas do estimador de duas listas incluem população fechada, correspondências corretas, probabilidades iguais de captura dentro de cada lista e independência entre listas. A fórmula não demonstra que duas ferramentas no navegador atendam a essas premissas.
Elas compartilham causas de falha. JavaScript pode estar desativado. Uma decisão de consentimento pode impedir o carregamento das duas tags. A pessoa pode fechar a página antes de qualquer evento sair. Uma regra de bloqueio pode atingir os dois endpoints de coleta. Visitas difíceis de observar para A também podem ser difíceis para B. Sem mais evidências, a suposição de independência não é segura.
Um exemplo histórico é a comparação do Plausible com o Google Analytics. A discussão no Hacker News questionou o denominador: visitas ausentes das duas ferramentas também estariam ausentes da comparação. Ela pode descrever a diferença entre aquelas implementações para aquele público. Não pode estabelecer uma taxa universal de bloqueio.
Uma chamada bem-sucedida à API do navegador também não prova ingestão. sendBeacon() retorna true quando o navegador coloca os dados na fila de envio. Não é um recibo do banco de dados de análise. Ao investigar a entrega, diferencie o enfileiramento, a aceitação pelo coletor e a presença do evento no relatório.
O log do servidor é outro mecanismo de observação
Usar um log HTTP como denominador ajuda a responder a outras perguntas. Não transforma requisições em pessoas.
Uma requisição pode vir de um crawler ou de uma prévia de link. Um navegador pode solicitar o mesmo documento repetidamente. O log da origem pode omitir requisições atendidas por um cache anterior. A camada de registro e o filtro de URL determinam a contagem. Comece por requisições de documentos no mesmo período, não por todas as imagens, scripts e verificações de disponibilidade.
O tráfego de IA exige outra distinção. A OpenAI documenta agentes separados para busca, rastreamento relacionado a treinamento e consultas iniciadas por usuários. Uma consulta para responder a alguém não prova que essa pessoa abriu seu site. Uma requisição de crawler não é uma visita humana encaminhada por um produto de IA. Mantenha as categorias separadas, mesmo quando o fornecedor for o mesmo.
A filtragem de bots também varia. O Google Analytics exclui automaticamente bots conhecidos, mas essa função não informa a quantidade excluída. Isso não garante o reconhecimento de toda automação. A Cloudflare descreve sua pontuação de bots como uma avaliação de probabilidade. Nem um user-agent semelhante ao de um navegador nem a ausência de um rótulo de bot prova que houve uma pessoa.
Se o servidor informa 10.000 e o navegador 6.000, restam 4.000 requisições sem explicação sob essas regras. Chamá-las de pessoas bloqueadas pula a investigação.
A contagem de visitantes depende da regra de identidade
Antes de comparar a coleta, verifique se os relatórios contam unidades equivalentes. Um carregamento de página pode emitir vários eventos. Vários carregamentos podem pertencer a uma sessão. Uma pessoa pode ter vários identificadores de dispositivo.
A identidade dos relatórios do GA4 pode usar User-ID, identificadores de dispositivo e, na configuração combinada, modelagem. Um relatório por dispositivo e outro que reúne atividades autenticadas não precisam retornar a mesma quantidade de usuários a partir dos mesmos eventos.
O Zenovay tem outro limite documentado em seu modo de identidade sem cookies: a chave de visitante muda diariamente. Voltar depois dessa mudança pode produzir outra chave. Pessoas com as mesmas entradas de identidade podem ser agrupadas. São consequências da regra de identidade, não necessariamente eventos removidos por um bloqueador. Aplicar um hash não transforma o identificador em um censo de pessoas.
Por isso nem sempre é possível reconstruir os visitantes únicos semanais somando os totais diários. Um identificador estável permite deduplicação entre dias; um identificador rotativo não oferece a mesma continuidade. Defina a janela de identidade antes de usar qualquer uma das contagens como denominador de uma taxa de conversão.
A atribuição muda a história depois da coleta
Mesmo que as duas ferramentas recebam a compra, elas podem discordar sobre quem recebe o crédito.
Primeiro, verifique o caminho disponível. Um parâmetro de campanha ou referenciador ausente pode apagar evidências de aquisição. Com Referrer-Policy: no-referrer, o navegador omite o referenciador. A política padrão entre origens normalmente envia a origem, não o caminho completo. Um relatório sem fonte utilizável não prova que alguém digitou o endereço.
Depois, confira a regra de distribuição. O Google descreve modelos de atribuição como regras ou algoritmos para distribuir crédito. Em seus relatórios de atribuição, visitas diretas normalmente não recebem crédito, exceto quando todo o caminho é direto. Uma ferramenta que credita simplesmente a última visita registrada pode discordar do GA4 sem perder uma compra. Janelas retrospectivas diferentes podem excluir contatos anteriores antes da execução do modelo.
Mudar a distribuição não altera a compra. Isso não recupera uma primeira visita não observada nem estabelece se a compra teria ocorrido sem uma campanha. Essa pergunta causal exige uma comparação planejada para respondê-la.
Concilie um evento antes de corrigir um total
Escolha um período completo e registre o que cada linha representa. Inclua fuso horário, hostnames cobertos, janela de identidade, tratamento de bots e presença de dados modelados. Anote quando exportou: o processamento pode alterar um período incompleto.
Depois, acompanhe uma ação específica com uma visita de teste autorizada. Confira a página de destino, o consentimento, a requisição tentada pelo navegador, a resposta do coletor e o evento armazenado. Se um identificador sintético for adequado, limite sua duração e mantenha-o fora dos relatórios de clientes. Não introduza uma identidade persistente entre ferramentas só para fazer dois totais coincidirem.
Para compras, concilie identificadores estáveis de transação e valores com o sistema de pagamentos, considerando reembolsos e período. Isso verifica compras registradas. Ainda não revela todas as pessoas que pensaram em comprar e saíram antes de serem observadas.
O resultado útil pode ser restrito: «B recebe estes eventos de teste e A não, sob esta configuração de bloqueio». Isso é reproduzível. «Recuperamos 22% das pessoas que faltavam» exige um denominador que os dois painéis não forneceram.