Supposons que deux outils de suivi fonctionnent sur la même page pendant une semaine. L’un enregistre 700 visites, l’autre 900. Il est tentant d’appeler cet écart « 200 visites bloquées ». Cette conclusion exige des informations qu’aucun des deux totaux ne contient.
Même en supposant une seule visite par personne et un comptage parfait de chaque événement reçu, le nombre de visites manquées par les deux outils reste inconnu. Les totaux ne disent même pas quelles visites ils ont en commun.
Cela compte lorsqu’on utilise le plus grand total pour corriger le plus petit. Le rapport entre deux populations observées ne mesure pas la population absente des deux.
La cellule manquante
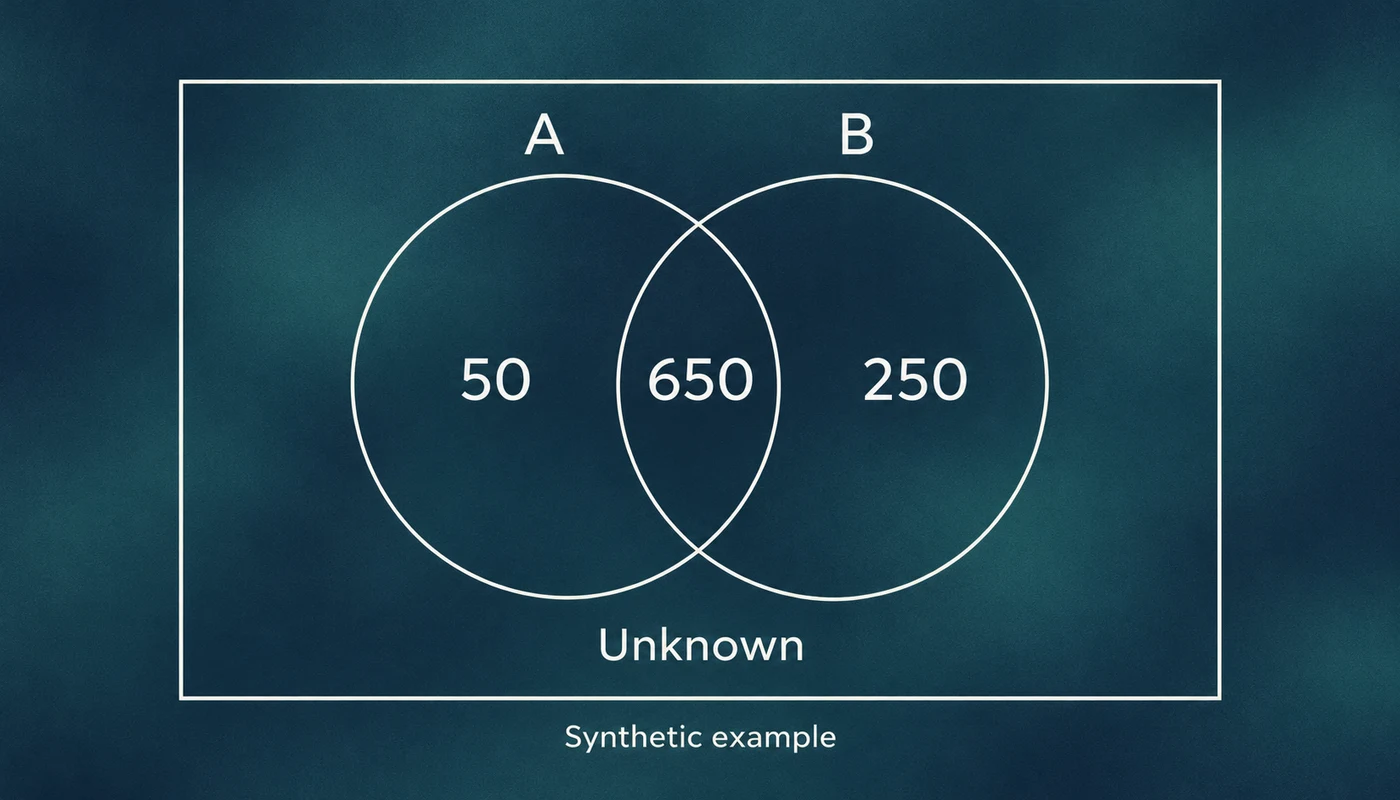
Voici un exemple synthétique, pas du trafic Zenovay. Sur une période fixe de sept jours, chaque visite admissible a exactement une occasion d’envoyer un événement à chaque outil. Tous les événements reçus sont valides et les deux systèmes définissent une visite de la même manière.
| Observation | Visites |
|---|---|
| Reçues par les deux outils | 650 |
| Reçues uniquement par A | 50 |
| Reçues uniquement par B | 250 |
| Reçues par aucun des deux | Inconnu |
A annonce 700, B annonce 900. Ensemble, ils ont observé 950 visites distinctes. Leur écart est de 200, alors que B a observé 250 visites absentes de A, et A en a observé 50 absentes de B.
Sans connaître le chevauchement des événements, même l’union de 950 est inconnue. Avec ce chevauchement, la cellule non observée reste inconnue. Ajoutez 50 visites reçues par aucun outil : le total atteint 1 000. Ajoutez-en plutôt 1 050 : il atteint 2 000. Les chiffres des deux tableaux de bord ne changent pas.
# Synthetic visits during one seven-day window.
tracker_a = set(range(700))
tracker_b = set(range(650)) | set(range(700, 950))

assert len(tracker_a) == 700
assert len(tracker_b) == 900
assert len(tracker_a & tracker_b) == 650
assert len(tracker_a | tracker_b) == 950

for unseen in (50, 1050):
    total = len(tracker_a | tracker_b) + unseen
    print(total, round(100 * len(tracker_a) / total, 1))
1000 70.0
2000 35.0
Les mêmes observations sont compatibles avec une couverture de 70 % ou de 35 % par A. Ce sont des possibilités construites, pas des estimations de couverture réelle.
Pourquoi les mêmes visites échappent aux deux outils
Un calcul idéalisé de capture-recapture pourrait estimer la population à 700 * 900 / 650, soit environ 969 visites. Les hypothèses de l’estimateur à deux listes comprennent une population fermée, un appariement correct, des probabilités de capture égales dans chaque liste et l’indépendance entre listes. La formule n’établit pas que deux outils exécutés dans un navigateur satisfont ces hypothèses.
Ils partagent des causes d’échec. JavaScript peut être désactivé. Un choix de consentement peut empêcher le chargement des deux balises. Une personne peut fermer la page avant tout envoi. Une règle de blocage peut viser les deux points de collecte. Les visites difficiles à observer pour A peuvent aussi l’être pour B. Sans éléments supplémentaires, l’hypothèse d’indépendance est donc fragile.
Un exemple historique est la comparaison de Plausible avec Google Analytics. La discussion sur Hacker News interrogeait le dénominateur : les visites absentes des deux outils étaient aussi absentes de la comparaison. Celle-ci peut décrire l’écart entre ces implémentations pour ce public. Elle ne peut pas établir un taux universel de blocage.
Un appel d’API réussi ne prouve pas non plus l’ingestion. sendBeacon() renvoie true lorsque le navigateur met les données en file d’attente. Ce n’est pas un accusé de réception de la base analytics. Pour examiner la livraison, distinguez la mise en file, l’acceptation par le collecteur et la présence de l’événement dans le rapport.
Le journal serveur est un autre mécanisme d’observation
Prendre un journal HTTP comme dénominateur aide à répondre à d’autres questions. Cela ne transforme pas les requêtes en personnes.
Une requête peut provenir d’un robot ou d’un service d’aperçu de lien. Un navigateur peut demander plusieurs fois le même document. Un journal d’origine peut omettre les requêtes servies par un cache en amont. La couche de journalisation et le filtre d’URL déterminent le comptage. Commencez par les requêtes de documents sur la même période, pas par l’ensemble des images, scripts et tests de disponibilité.
Le trafic lié à l’IA demande une autre distinction. OpenAI documente des agents séparés pour la recherche, l’exploration liée à l’entraînement et les consultations déclenchées par un utilisateur. Une consultation pour répondre à une question ne prouve pas que la personne a ouvert votre site. Une requête de robot n’est pas une visite humaine provenant d’un produit d’IA. Séparez ces catégories, même pour un fournisseur commun.
Le filtrage des robots varie aussi selon les produits. Google Analytics exclut automatiquement les robots connus, sans afficher leur nombre dans cette fonctionnalité. Cela ne garantit pas la détection de toute automatisation. Cloudflare présente son score de bot comme une estimation de probabilité. Ni un user-agent ressemblant à celui d’un navigateur ni l’absence d’étiquette de bot ne prouve une origine humaine.
Si le serveur annonce 10 000 et le navigateur 6 000, les 4 000 restants sont des requêtes inexpliquées selon ces règles. Les appeler des humains bloqués revient à sauter l’enquête.
Le nombre de visiteurs dépend d’une règle d’identité
Avant de comparer la collecte, vérifiez que les rapports comptent des unités équivalentes. Un chargement de page peut émettre plusieurs événements. Plusieurs chargements peuvent former une session. Une personne peut avoir plusieurs identifiants d’appareil.
L’identité de reporting de GA4 peut utiliser le User-ID, les identifiants d’appareil et, en mode hybride, la modélisation. Un rapport par appareil et un rapport regroupant les activités connectées ne donnent pas nécessairement le même nombre d’utilisateurs à partir des mêmes événements.
Zenovay a une autre limite documentée dans son mode d’identité sans cookies : la clé visiteur change chaque jour. Revenir après cette frontière peut produire une nouvelle clé. Des personnes partageant les mêmes données d’identité peuvent être regroupées. Ce sont des conséquences de la règle d’identité, pas nécessairement des événements supprimés par un bloqueur. Hacher les données ne transforme pas l’identifiant en recensement de personnes.
C’est pourquoi additionner les visiteurs uniques quotidiens ne permet pas toujours de reconstituer les visiteurs uniques hebdomadaires. Un identifiant stable peut être dédupliqué entre journées ; un identifiant renouvelé n’offre pas la même continuité. Convenez de la fenêtre d’identité avant d’utiliser l’un de ces nombres comme dénominateur d’un taux de conversion.
L’attribution modifie le récit après la collecte
Même si les deux outils reçoivent l’achat, ils peuvent diverger sur le crédit à lui attribuer.
Vérifiez d’abord le parcours disponible. Un paramètre de campagne ou un référent manquant peut effacer un indice d’acquisition. Avec Referrer-Policy: no-referrer, le navigateur omet le référent. La politique par défaut entre origines envoie généralement l’origine, pas le chemin complet. L’absence de source exploitable ne prouve pas qu’une personne a saisi l’adresse.
Vérifiez ensuite la règle de répartition. Google décrit les modèles d’attribution comme des règles ou algorithmes de répartition du crédit. Dans ses rapports d’attribution, les visites directes ne reçoivent normalement pas de crédit, sauf si le parcours est entièrement direct. Un outil qui crédite simplement la dernière visite enregistrée peut donc diverger de GA4 sans perdre d’achat. Des fenêtres rétrospectives différentes peuvent exclure des contacts avant même le calcul du modèle.
Changer la répartition ne change pas l’achat. Cela ne retrouve pas une première visite non observée et ne démontre pas que l’achat n’aurait pas eu lieu sans campagne. Il faut une comparaison conçue pour cette question causale.
Rapprocher un événement avant de corriger un total
Choisissez une période de reporting complète et notez ce que représente chaque ligne. Précisez le fuseau horaire, les hôtes couverts, la fenêtre d’identité, le traitement des robots et l’éventuelle présence de données modélisées. Notez aussi la date d’export, car le traitement peut modifier une période incomplète.
Puis tracez une action précise avec une visite de test autorisée. Vérifiez la page de destination, le consentement, la requête tentée par le navigateur, la réponse du collecteur et l’événement stocké. Si un identifiant synthétique convient, limitez sa durée et excluez-le des rapports clients. N’introduisez pas d’identité persistante entre outils uniquement pour faire coïncider deux totaux.
Pour les achats, rapprochez les identifiants de transaction stables et les montants du système de paiement, en tenant compte des remboursements et de la période. Cela vérifie les achats enregistrés. Cela ne révèle toujours pas toutes les personnes qui ont envisagé d’acheter puis sont parties avant d’être observées.
Le résultat utile peut être limité : « B reçoit ces événements de test, A ne les reçoit pas avec cette configuration de blocage. » C’est reproductible. « Nous avons retrouvé 22 % des personnes manquantes » nécessite un dénominateur que les deux tableaux de bord n’ont pas fourni.